
在小語言模型(SLM)快速發展的今天,可用的開源基座相當豐富。Gemma、Qwen、Phi 各自都有多種尺寸,Benchmark 分數也都相當亮眼。
然而,對於「訓練一個專門操作工具的 Agent 模型」這個特定目標而言,Benchmark 分數並不是最重要的判準。真正會影響專案成敗的,是四個相當實務的工程條件。
除此之外,今天還要補上一塊 Day 15 只講了用法、沒講原理的拼圖:Loss Mask 到底在遮蔽什麼? 昨天我們知道要設 assistant_only_loss=True,但如果不理解它背後的機制,就無法在它靜默失效時察覺問題。
以下的內容,將會說明選型的四個判準、候選模型的比較、PEFT 策略的取捨,以及 Loss Mask 的實際運作方式。
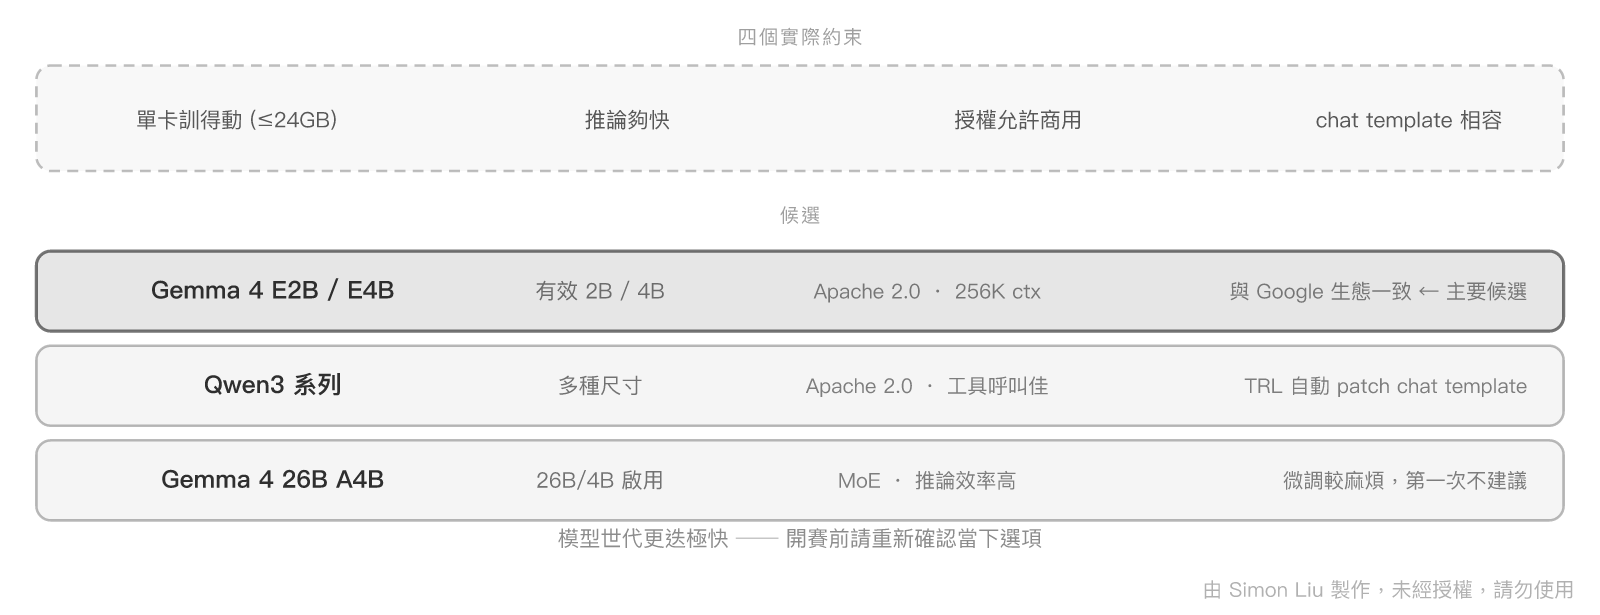
先明確列出判準,否則在眾多候選之間,很容易被 Benchmark 分數帶著走:
assistant_only_loss: 這一項最容易被忽略,卻會直接影響開發時間 —— 若選了 TRL 沒有內建模板支援的模型,就得自行修改 Jinja 模板。2026-04-02 發布,採 Apache 2.0 授權,提供五種尺寸:
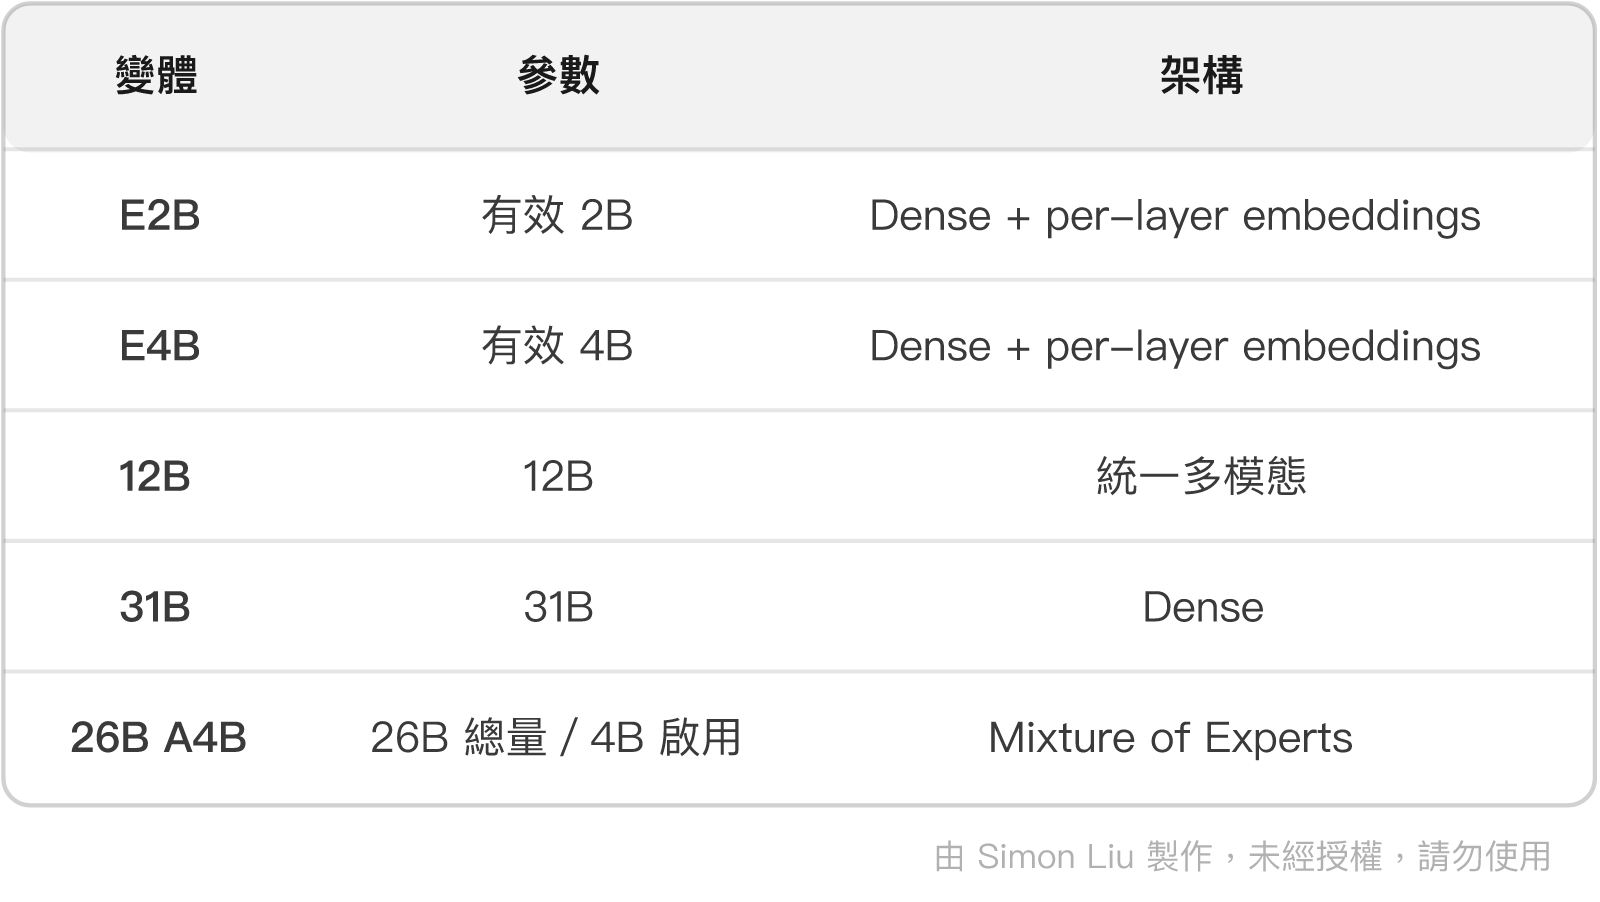
共同特性包括長上下文(E2B / E4B 為 128K,其餘三個變體 256K)、140 種以上語言支援,以及多模態能力(文字與影像輸入,E2B / E4B / 12B 另支援音訊)。
本系列的主要候選是 E2B 與 E4B,理由有三:單卡輕鬆訓練甚至能在筆電上推論;與前半段的 Google 生態一致;多語支援對中文差勤場景有利。而 E2B / E4B 的 128K 上下文遠超我們的需求(Agentic 樣本大約 2K),完全不必擔心截斷。
至於 26B A4B 這個 MoE 變體,推論時只啟用 4B 參數、品質卻高於 4B 級別,在推論資源充足但訓練資源不足時是有趣的選項。不過 MoE 的微調比 dense 麻煩(TRL 提供 router_aux_loss_coef 處理負載均衡輔助損失),第一次做不建議。
同樣採 Apache 2.0 授權,在工具呼叫與 agentic 任務上口碑良好,生態成熟 —— 量化版本與部署範例都相當豐富。
它有一個相當實際的優勢:TRL 明確把 Qwen3 列為會自動 patch chat template 的家族,因此上一節提到的 {% generation %} 標記問題,用 Qwen3 就不必自行處理。
模型世代更迭極快。Gemma 4 發布於 2026-04,Qwen3 生態也持續在演進。實際動手前請重新確認當下的選項,別讓文章一發表就過時。
這不是和稀泥,而是因為成本很低而資訊量很高:資料集是同一份、LoRA 訓練 4B 以下的模型通常一兩個小時就完成,而 ADEval 的 benchmark 指令本來就支援多模型並排比較。
「哪個基座更適合這類 agentic 任務」本身就是值得寫的結論,而且是這個系列少數能給出實測答案的問題。
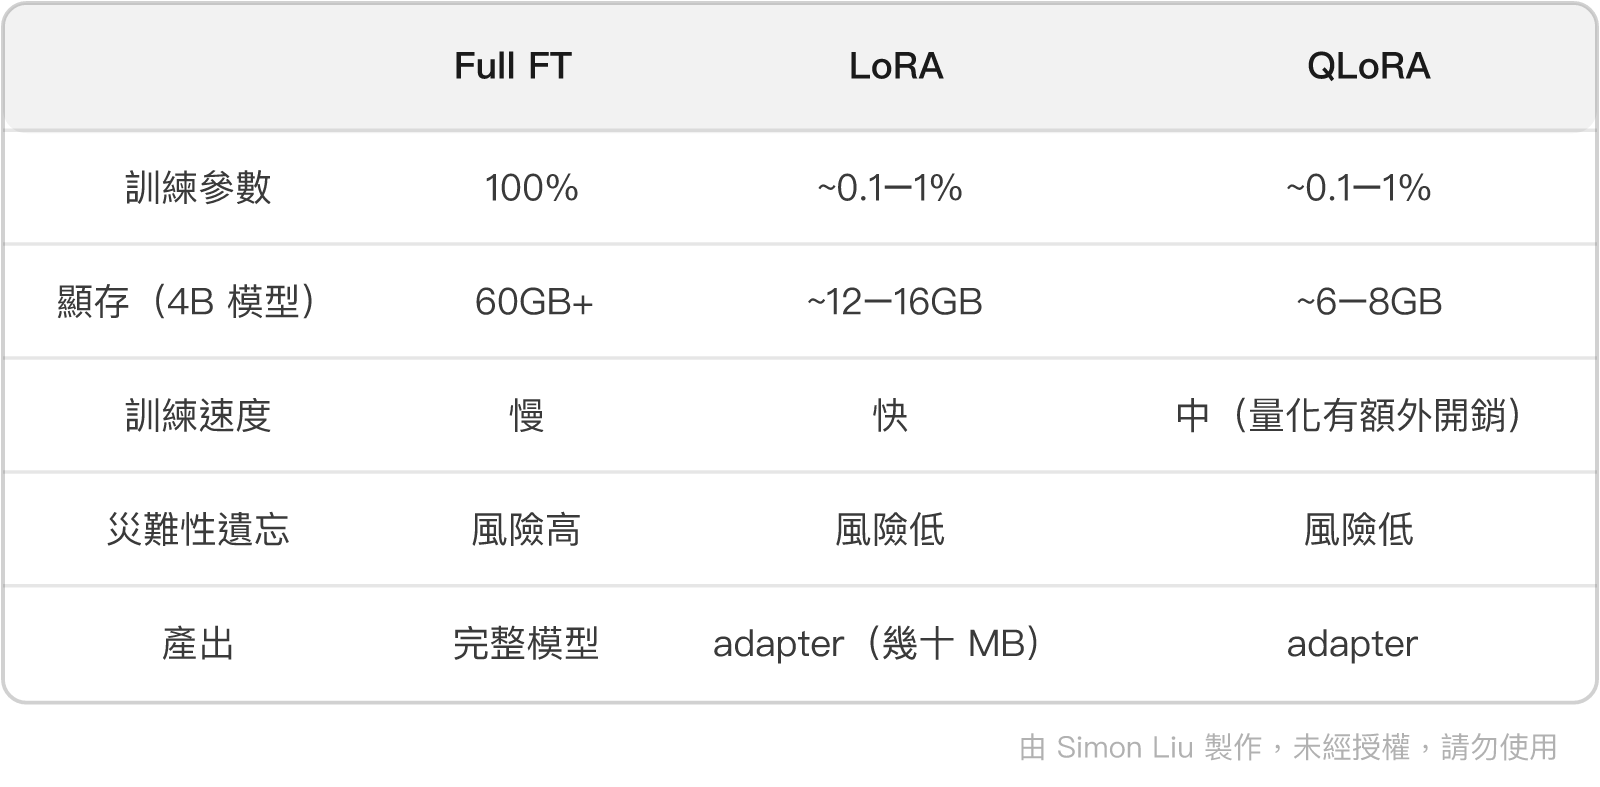
本系列採用 LoRA。 4B 模型加上 LoRA 在 24GB 卡上相當寬裕,沒有必要為了節省顯存而承受 QLoRA 的量化損失與速度損失。
災難性遺忘那一列值得多說一句。我們的資料集只有幾千筆、領域極窄(請假工具),Full FT 很可能讓模型「只會這件事」,通用能力嚴重退化 —— 而那正是 Day 14 引入 Twinkle Eval 要監控的風險。LoRA 只調整極少數參數,基座能力大致保留。
補充一點實務經驗:我在先前那個 kubectl-mcp-server 的研究中採用的是全參數微調,當時的資料規模與領域特性與本系列不同。兩條路都可行,關鍵在於評估您能接受多少通用能力的退化 —— 而這正是需要 TMMLU+ 這類標準 Benchmark 來量測的原因。
from datasets import load_dataset
from trl import SFTTrainer
from peft import LoraConfig

dataset = load_dataset("json", data_files="train.jsonl", split="train")

trainer = SFTTrainer(
    "google/gemma-4-E4B",
    train_dataset=dataset,
    peft_config=LoraConfig(),
)
trainer.train()
若要使用 QLoRA,加上量化設定即可:
from transformers import BitsAndBytesConfig

trainer = SFTTrainer(
    "google/gemma-4-E4B",
    train_dataset=dataset,
    peft_config=LoraConfig(),
    quantization_config=BitsAndBytesConfig(load_in_4bit=True),
)
一個容易踩的坑:SFTConfig 的 learning_rate 預設是 2e-5,那是為 Full Fine-Tuning 設計的。TRL 文件明確建議 LoRA 使用約 1e-4 —— 用預設值訓 LoRA,會看到 loss 下降得極慢,很容易被誤判為資料有問題。
Day 15 說明了「tool 角色不該計入 loss」以及 assistant_only_loss=True 的用法。但要能在它失效時察覺,需要理解底層機制。
SFT 使用的是 token-level cross-entropy loss:模型在每個位置預測下一個 token,並與實際的下一個 token 比對。因此訓練時會把輸入序列右移一位,形成目標標籤。
而「不計入 loss」的實作方式,是把對應位置的標籤設為 -100(PyTorch 交叉熵的預設 ignore index)。被標記為 -100 的位置,完全不參與損失計算與梯度更新。
換句話說,Loss Mask 並不是「把那些 token 刪掉」,而是「讓模型仍然看得到它們作為上下文,但不要求它去生成它們」。
這個區別相當關鍵:
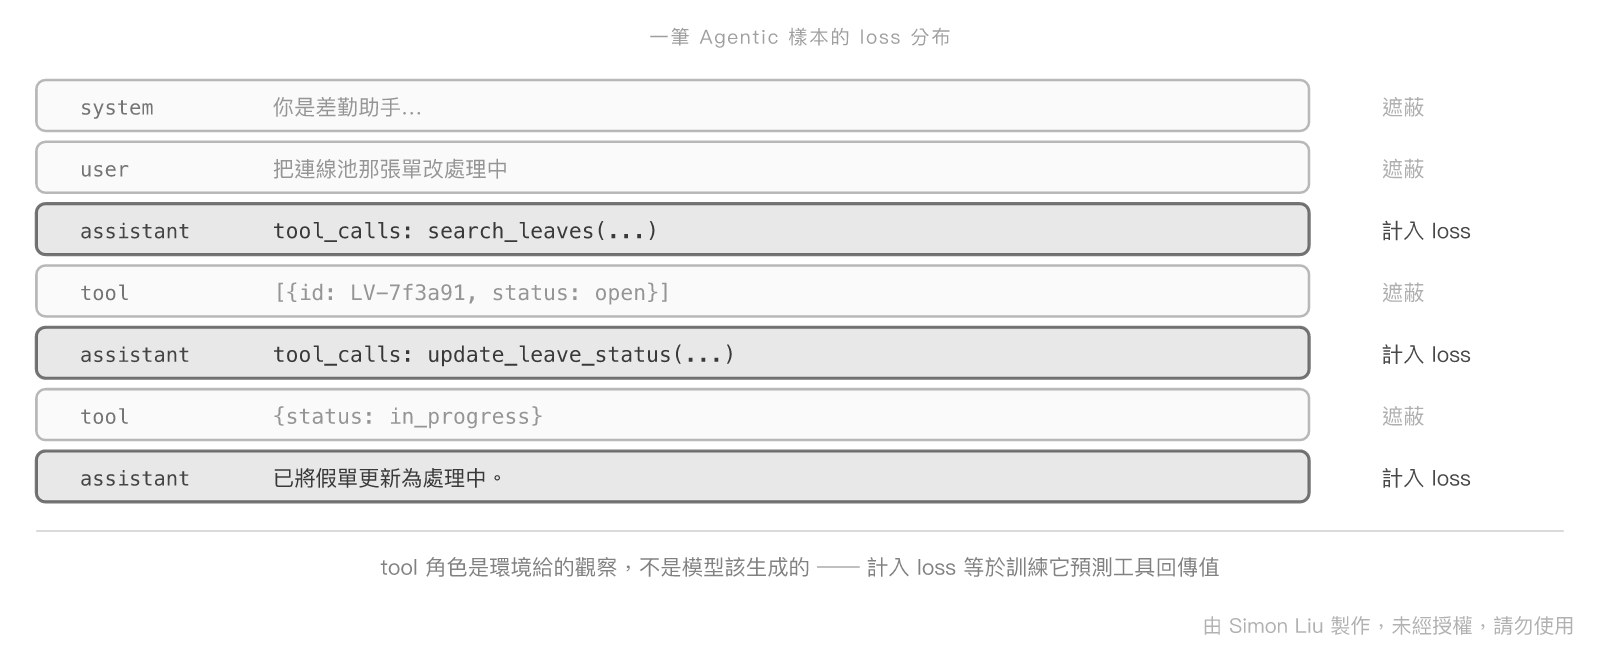
tool 回傳的內容必須留在上下文裡,否則模型無從得知查詢結果。TRL 提供三個相關參數,適用場景不同:
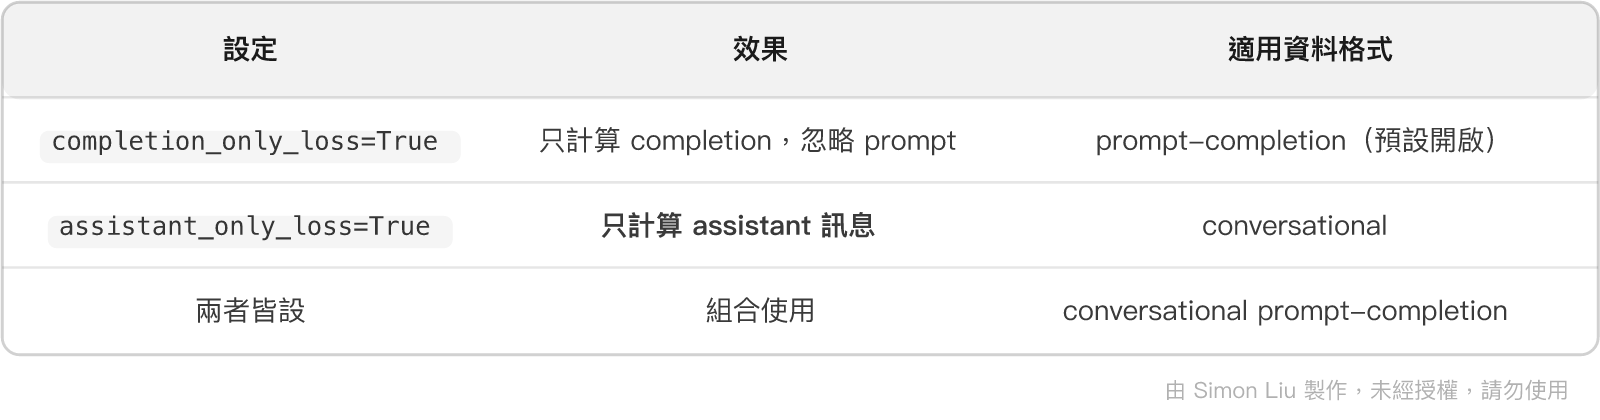
本系列的資料是 conversational 格式,因此需要的是 assistant_only_loss=True。
若 chat template 缺少 {% generation %} 標記,這個設定會靜默失效,而症狀相當有欺騙性:
模型會把 user 與 system 訊息也算進 loss,而那些內容它在推理時「看得到」,預測起來相當容易 —— 於是 loss 掉得特別漂亮,mean_token_accuracy 也異常高。表面上訓練得很成功,實際上模型學到的是複述輸入。
判斷方式:觀察 mean_token_accuracy 的起始值。正常情況下模型一開始應該預測不準;若它從第一步就超過 0.9,八成是 mask 沒有生效。
Gemma 4 全面採用 Apache 2.0 授權,加上 E2B / E4B 這類單卡可訓的尺寸,讓「為特定任務打造專屬模型」的技術門檻降到相當低的位置。
總結來說,今天有三個重點值得帶走:
-100 標籤,而非刪除內容: tool 回傳必須留在上下文供模型參考,但不該被要求生成。理解這一點,才能在 mask 靜默失效時,從 mean_token_accuracy 的異常值察覺問題。明天處理訓練環境。考量到並非每個人都有本地 GPU,我們會走一條低成本的雲端路線 —— Google Colab 與 Colab CLI 工具鏈。
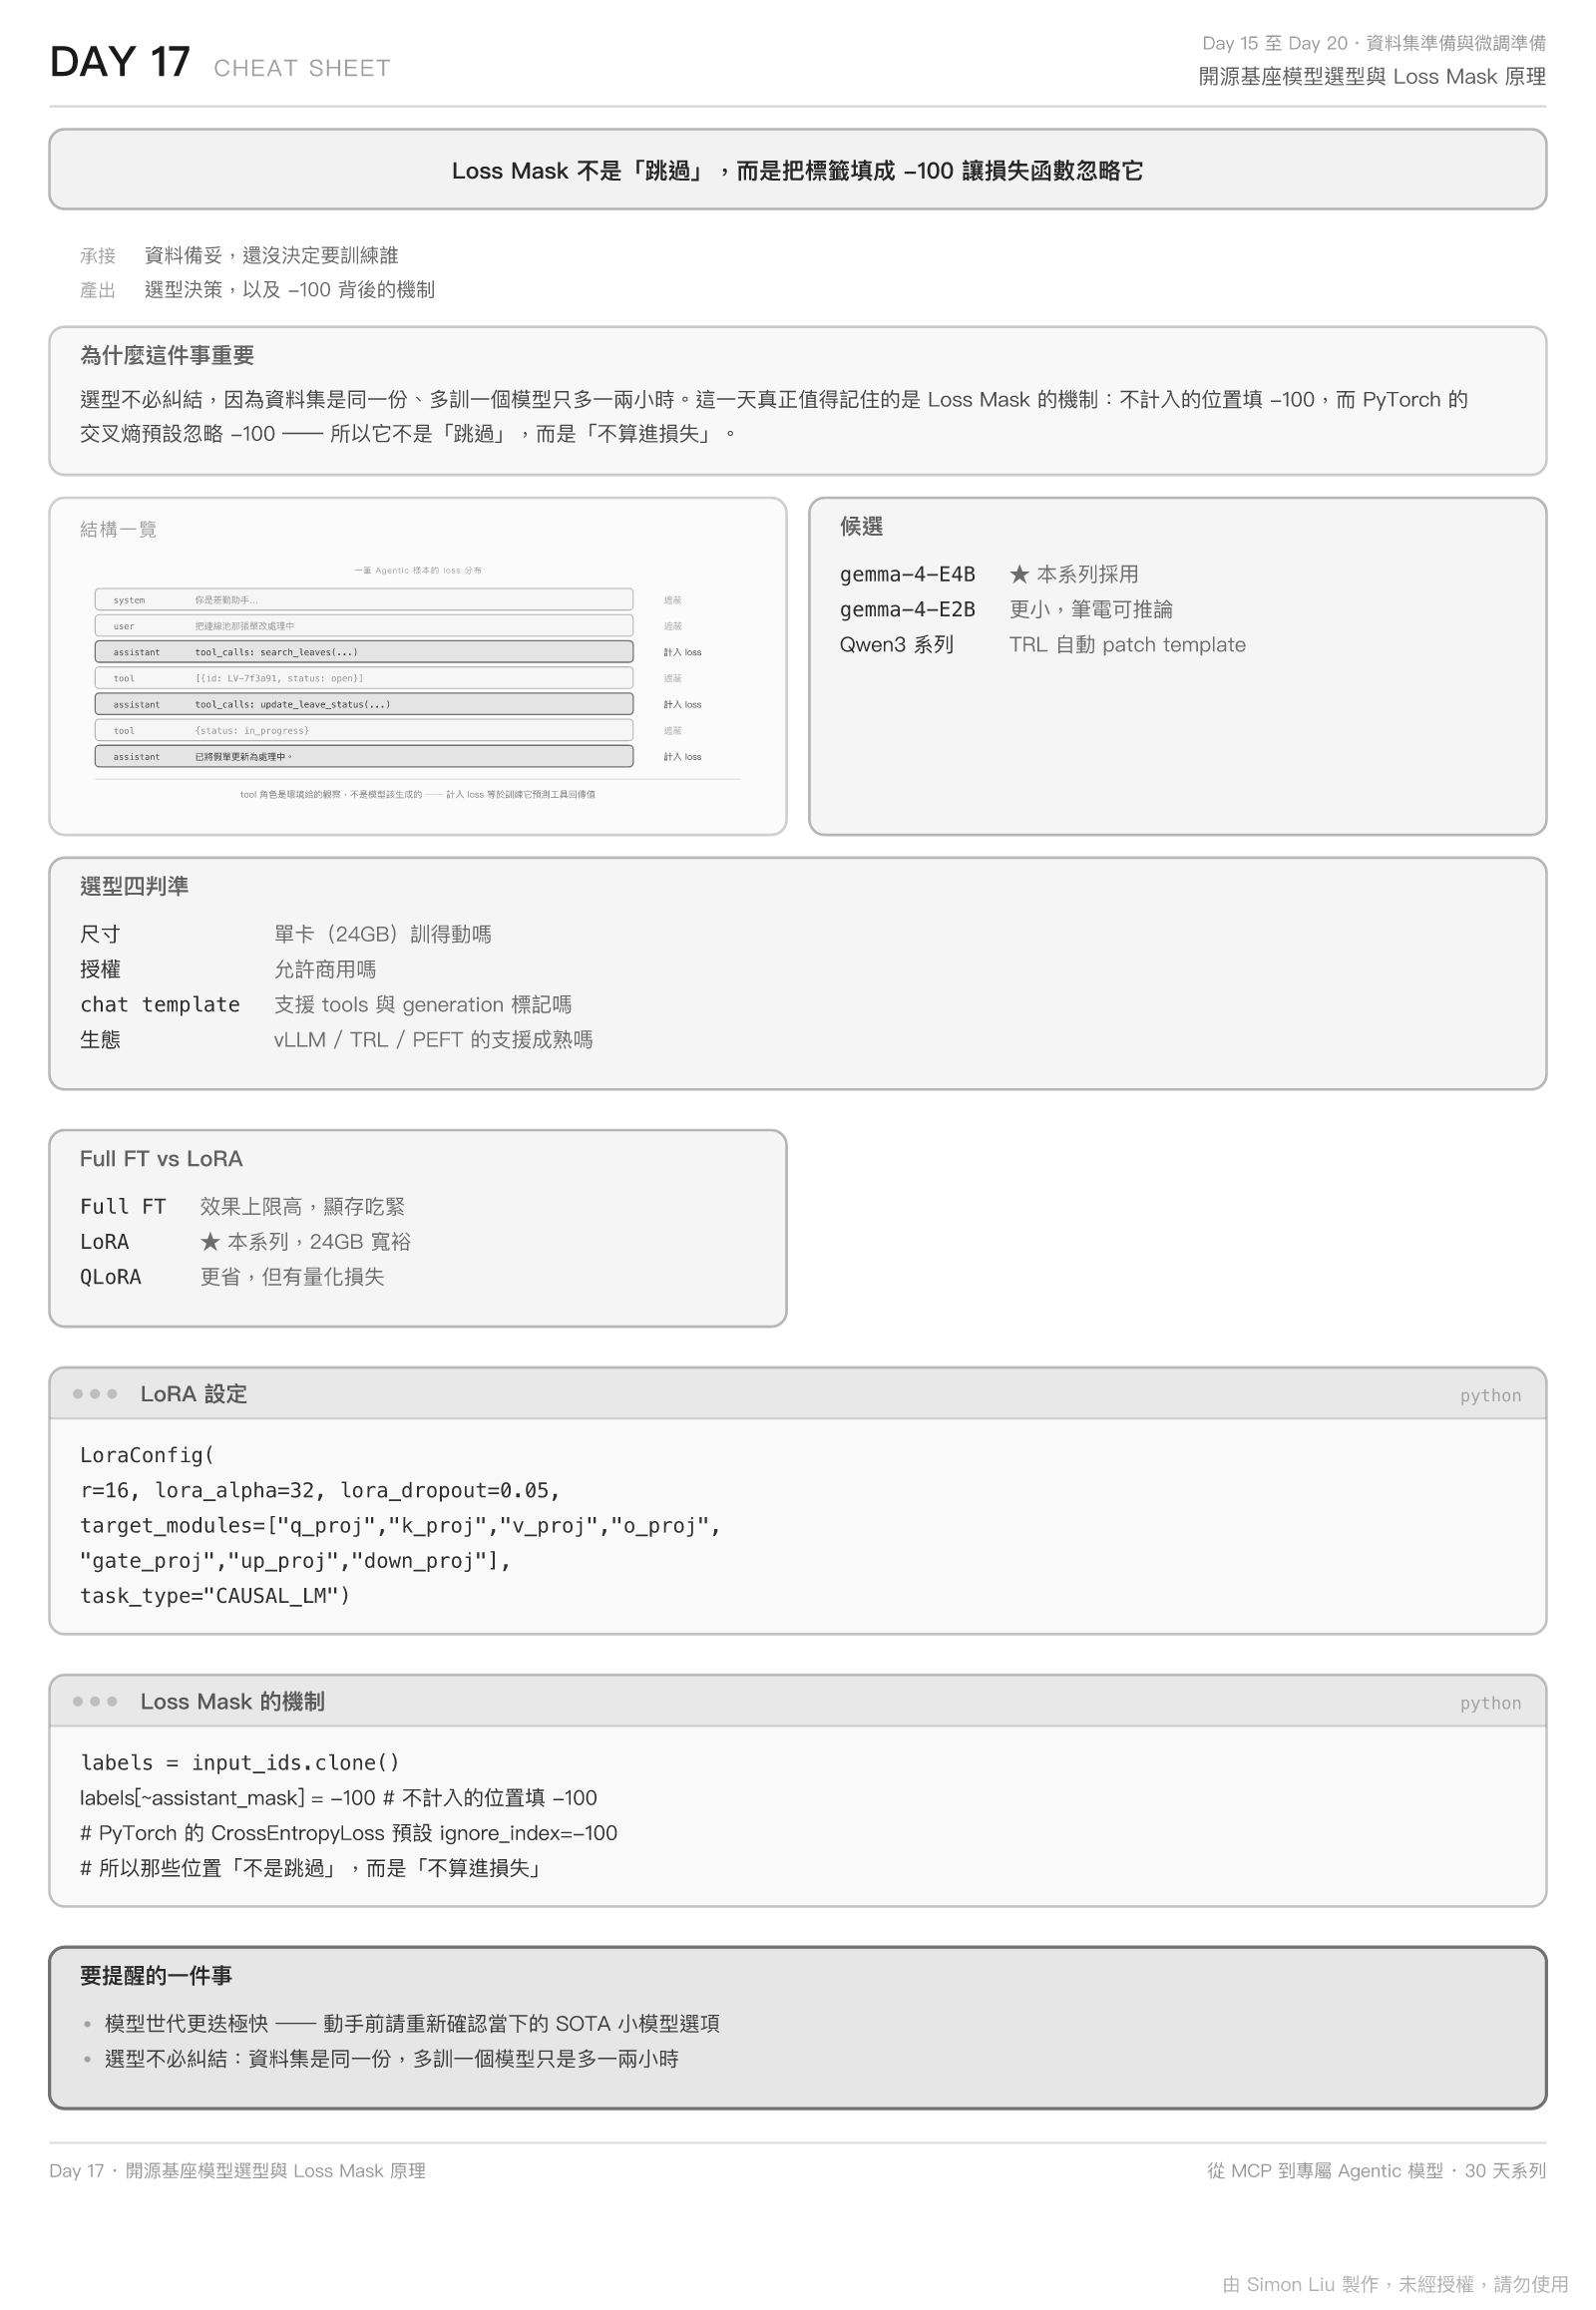
peft_config 整合、quantization_config 組成 QLoRA、LoRA 學習率建議、assistant_only_loss 與 label shifting、-100 ignore index、router_aux_loss_coef
LoraConfig 參數查證日期:2026-08-24
大家好,我是 Simon 劉育維,是一位 AI 領域解決方案專家,目前也擔任 Google Cloud AI 領域開發者專家 (GDE),期待能夠幫助企業導入人工智慧相關技術解決問題。如果這篇文章對您有幫助,歡迎在我的 Linkedin 上留言提供意見,並與我一起討論有關人工智慧的主題,期待能夠對大家有所幫助!
我的個人部落格資訊:https://medium.com/@simon3458


 iThome鐵人賽
 看影片追技術